Tu startup ya tiene un problema de datos si alguien en el equipo exporta CSVs cada semana, cruza métricas a mano y aún así nadie se fía del dashboard. Stripe dice una cosa, el CRM otra, producto mide otra distinta y finanzas termina cerrando el mes con un Excel paralelo. Eso no es un problema de reporting. Es un problema de infraestructura.
Ahí es donde entra un ETL Developer. No como un perfil accesorio de BI, sino como la persona que convierte sistemas sueltos en una fuente de verdad utilizable. Si estás creciendo en España y quieres operar con datos de clientes, facturación, activación o retención sin discutir cada cifra, necesitas a alguien que construya pipelines fiables, trazables y mantenibles.
Por qué tu startup necesita un ETL Developer (probablemente ahora)
El patrón se repite en muchas startups y scaleups españolas. Tienes pagos en Stripe, conversaciones en Intercom, eventos de producto en PostgreSQL, campañas en HubSpot y quizá logs en AWS. Cada sistema funciona bien por separado. Juntos, generan caos.
El primer síntoma no suele ser técnico. Suele ser de negocio. Marketing no puede atribuir ingresos con confianza, producto no sabe qué usuarios activan de verdad y finanzas pierde tiempo reconciliando fuentes. Cuando pasa eso, no necesitas otro dashboard. Necesitas ordenar la cadena que alimenta ese dashboard.
Cuando el dato existe pero no sirve
Un buen ETL Developer resuelve justo ese cuello de botella. Extrae datos de sistemas distintos, los transforma con reglas consistentes y los carga en un repositorio donde el equipo puede analizarlos sin pelearse por definiciones. Ese repositorio puede ser BigQuery, Snowflake o incluso una base bien estructurada si estás en una fase más temprana.
La clave no es “tener datos”. La clave es que el dato llegue limpio, con lógica de negocio compartida y sin procesos manuales escondidos. Si no, tu startup opera con versiones enfrentadas de la realidad.
Regla práctica: si tu equipo depende de exports manuales para cerrar métricas críticas, ya vas tarde para contratar este perfil.
En España, esta necesidad no es teórica. El 34,3% de las empresas de 10 o más empleados ya realizaba análisis de big data en 2023, frente al 13,8% de 2018, un salto de 20,5 puntos porcentuales en cinco años , según el INE citado en este análisis sobre ETL Developer y mercado de datos. Eso explica por qué el rol sigue siendo estratégico: cada vez más empresas quieren explotar datos, pero eso solo funciona si alguien construye la base técnica.
Lo que cambia cuando contratas bien
Cuando incorporas a un ETL Developer sólido, pasan tres cosas:
- Se unifican definiciones críticas. Cliente activo, MRR, pedido válido, churn o conversión dejan de depender de quién hizo la query.
- Se reduce la dependencia operativa. El equipo deja de perseguir CSVs, copiar fórmulas y rehacer joins cada semana.
- Mejora la velocidad de decisión. El dato no llega perfecto por arte de magia, pero sí llega de forma repetible.
Si tu equipo aún está discutiendo qué significa cada métrica, te conviene revisar primero cómo funciona el ecosistema de datos que hay detrás en esta guía de big data y su aplicación real en empresas.
Qué hace un ETL Developer y por qué no es un Data Engineer
Un ETL Developer no “mueve datos” sin más. Su trabajo consiste en diseñar cómo entran datos desde múltiples sistemas, cómo se limpian y cómo se dejan listos para análisis sin romper consistencia por el camino. Si reporting falla, si las tablas no cuadran o si cada fuente trae formatos incompatibles, este perfil es el que pone orden.
La forma más simple de explicarlo es esta: piensa en un chef.
Extraer, transformar y cargar sin romantizarlo
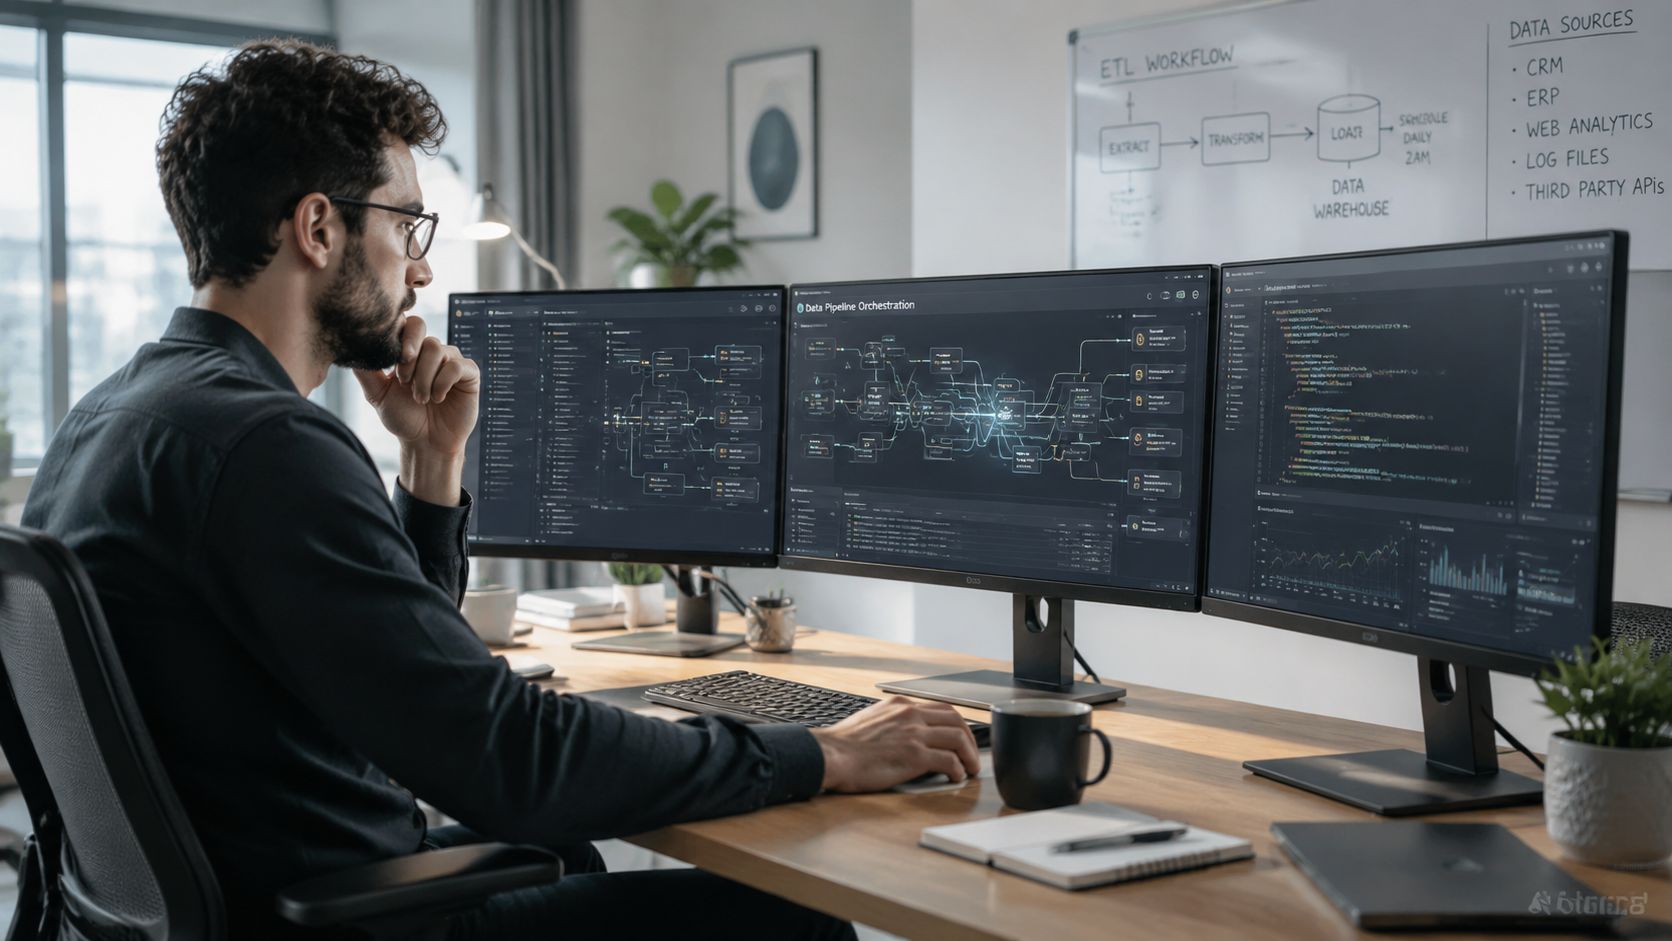
Extract es salir a por ingredientes. El ETL Developer recoge datos de APIs, CRM, bases transaccionales, ficheros planos o herramientas SaaS. Si una fuente cambia su esquema, falla una autenticación o llega información duplicada, ahí empieza el trabajo real.
Transform es la cocina. Se limpian nulos, se normalizan fechas, se aplican reglas de negocio, se resuelven duplicados y se unen entidades. Aquí se decide si “cliente” significa email único, cuenta activa o empresa con contrato vigente. Si esa capa está mal, todo lo que viene después también.
Load es emplatar. Los datos ya preparados se cargan en el destino final para que analistas, equipos de producto o finanzas trabajen con ellos sin rehacer el proceso desde cero.
En entornos de BI y data warehouse, el ETL Developer garantiza que la capa analítica reciba datos íntegros y reutilizables desde múltiples fuentes , especialmente cuando hay esquemas heterogéneos o volumen alto, como explica este análisis comparativo entre ETL Developer y Data Engineer.
El error más común al abrir la vacante
Muchos CTOs piden un Data Engineer cuando en realidad necesitan un ETL Developer. Es un error caro. El Data Engineer suele cubrir un perímetro más amplio: arquitectura de datos, procesamiento distribuido, streaming, infraestructura cloud compleja y, a veces, soporte a casos de ML.
El ETL Developer es más específico. Está centrado en la integración, la calidad, el modelado para analítica y la fiabilidad del pipeline.
Si tu problema principal es consolidar datos operativos para analytics, contratar un perfil demasiado orientado a infraestructura pesada suele ser mala puntería.
Cómo decidir qué rol necesitas
Busca un ETL Developer si necesitas:
- Integrar fuentes de negocio como Stripe, Salesforce, HubSpot, PostgreSQL o ficheros desde S3.
- Construir un warehouse usable para reporting, métricas de producto o cuadros financieros.
- Aplicar lógica de negocio estable sobre datos que hoy viven dispersos.
- Corregir inconsistencias entre dashboards, queries y equipos.
Busca un Data Engineer si necesitas además:
- Procesamiento en tiempo real con herramientas tipo Kafka.
- Arquitecturas más amplias con lagos de datos, compute distribuido o Spark.
- Infraestructura de plataforma de datos para varios equipos y múltiples casos de uso.
- Capas de soporte a ML o MLOps.
Si estás dudando entre ambos perfiles, esta comparativa sobre Ingeniero de datos y responsabilidades reales en startups te ayuda a separar bien el alcance.
Responsabilidades y tareas clave en el día a día
El día a día de un buen ETL Developer se parece poco a la idea simplona de “hacer integraciones”. Su trabajo mezcla diseño, implementación, validación y mantenimiento. Si en tu empresa este rol acaba solo corrigiendo SQL rota o parcheando imports, has definido mal la posición.
Extracción con criterio
La extracción no consiste en “conectar cosas”. Consiste en hacerlo sin romper sistemas origen y sin traer basura innecesaria. Un ETL Developer competente sabe cuándo leer desde una API de terceros, cuándo consumir un volcado programado y cuándo consultar una base operativa con límites claros.
Algunos ejemplos habituales en startups:
- APIs SaaS como Stripe, Salesforce, HubSpot o Zendesk.
- Bases transaccionales como PostgreSQL o MySQL, donde hay que evitar queries agresivas en producción.
- Ficheros CSV o JSON en Amazon S3, Google Cloud Storage o cargas manuales de partners.
Transformación que aguanta auditoría interna
Aquí está el núcleo del rol. Transformar significa limpiar, estandarizar y enriquecer el dato para que el negocio lo use sin dudas. Fechas en formatos distintos, monedas mezcladas, IDs inconsistentes o usuarios duplicados no son excepciones. Son la normalidad.
Un ETL Developer serio aplica reglas como estas:
- Normalización de fechas, divisas, nombres de campos y estados.
- Limpieza de nulos, registros corruptos y duplicados.
- Enriquecimiento al cruzar comportamiento de producto con datos comerciales o de facturación.
- Modelado para dejar tablas reutilizables por analistas y equipos de BI.
Según AltexSoft sobre el rol y las habilidades del ETL Developer, un perfil experto no solo implementa el proceso. También diseña la arquitectura del pipeline, define el modelo de datos y valida calidad y consistencia.
Un mal ETL Developer entrega pipelines que “corren”. Uno bueno entrega datos en los que tu equipo puede confiar.
Carga, orquestación y operaciones
La fase de carga no es el final. Es el comienzo de la parte operativa. Los datos transformados tienen que llegar al destino correcto, con la granularidad correcta y con un esquema que no destruya el trabajo del equipo analítico cada vez que cambia una fuente.
En la práctica, esto implica:
- Cargar en warehouses como BigQuery, Snowflake o Redshift con particionado y lógica incremental cuando toca.
- Orquestar jobs con Apache Airflow, Dagster o Prefect para que dependencias y horarios no sean un caos.
- Monitorizar fallos para detectar jobs rotos, retrasos o anomalías de calidad.
- Documentar pipelines con suficiente detalle para que otra persona pueda mantenerlos sin ingeniería inversa.
Lo que debes esperar de verdad
Si contratas bien, este perfil debería asumir responsabilidades como:
- Diseñar pipelines completos , no solo tareas sueltas.
- Hablar con analistas y negocio para entender reglas y definir entidades.
- Proponer mejoras de modelo de datos cuando ve fricción repetida.
- Detectar deuda técnica antes de que afecte a reporting, forecasting o decisiones de producto.
Si el candidato no sabe explicar cómo depuraría una carga fallida, cómo modelaría una tabla de hechos o cómo validaría consistencia entre origen y destino, no estás ante un ETL Developer sólido. Estás ante alguien que ha usado herramientas de datos.
Stack tecnológico y herramientas habituales
El stack de un ETL Developer no se evalúa por cantidad de logos en el CV. Se evalúa por coherencia. Tu startup no gana nada contratando a alguien que ha tocado veinte herramientas si no domina las pocas que resuelven vuestro caso con fiabilidad.
Lenguajes que sí importan
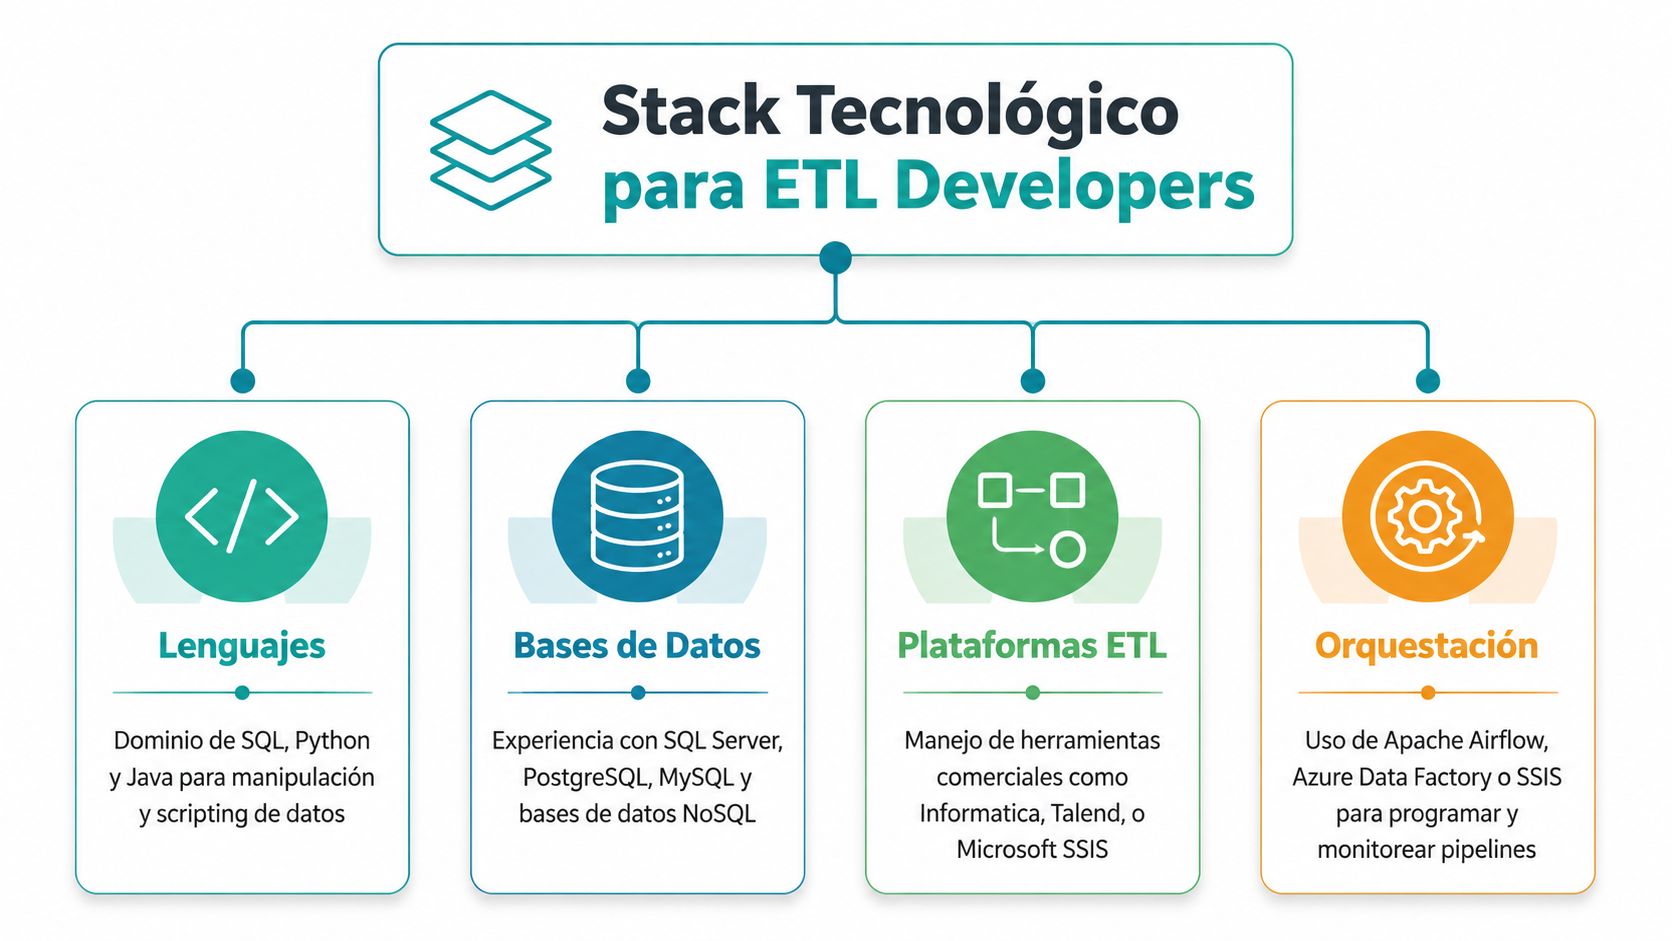
SQL es obligatorio. No negociable. Si el candidato no piensa bien en SQL, no va a modelar datos, optimizar transformaciones ni validar resultados con soltura. Puedes tolerar menos profundidad en otras áreas. En SQL, no.
Python suele ser el segundo pilar. Hace falta para scripting, transformaciones personalizadas, integraciones con APIs, automatizaciones y pruebas. En algunos entornos aparece Java o Scala, pero para una startup española media, SQL más Python suele ser la combinación más útil.
Herramientas modernas frente a legado corporativo
Aquí conviene ser brutalmente práctico. En startups y scaleups, el stack moderno suele dar mejor velocidad de ejecución que el stack enterprise clásico.
Dos patrones habituales:
- ETL tradicional con herramientas como Informatica, Talend o SSIS. Encaja más en corporaciones, contextos legacy y equipos con mucha gobernanza formal.
- ELT moderno con Fivetran o Airbyte para ingestión, dbt para transformación y un warehouse cloud como centro de gravedad. Suele encajar mejor en empresas de producto con equipos pequeños.
No contrates a alguien obsesionado con una sola herramienta. Contrata a quien entienda el patrón. Un profesional fuerte sabe cuándo usar conectores gestionados y cuándo construir algo a medida.
Bases de datos y warehouses
Un ETL Developer útil para startup debería moverse con comodidad entre:
- Relacionales como PostgreSQL o MySQL.
- Warehouses cloud como BigQuery, Snowflake o Amazon Redshift.
- Entornos con algo de NoSQL cuando una fuente lo exija.
Lo importante no es haber administrado todas. Lo importante es comprender cómo modelar para analítica, cómo mover datos sin degradar rendimiento y cómo mantener consistencia entre origen y destino.
Criterio de hiring: prioriza candidatos que expliquen decisiones de modelado y carga. La lista de herramientas, por sí sola, vale poco.
Orquestación y mantenimiento
Todo pipeline serio necesita una capa de orquestación. Apache Airflow sigue siendo una referencia clara, pero Dagster y Prefect aparecen cada vez más en equipos que quieren menos fricción de mantenimiento. Azure Data Factory también entra en juego si tu stack vive en Microsoft.
En esta parte, conviene valorar:
- Gestión de dependencias entre tareas
- Reintentos y alertas
- Observabilidad básica
- Versionado de cambios
- Capacidad para documentar y operar el flujo
Una vacante bien escrita debería pedir menos “experiencia en X años con Y” y más capacidad para resolver integración, transformación, modelado y operación sobre herramientas concretas. Si necesitas apoyo para definir ese perfil antes de salir a mercado, una agencia especializada en recruiting técnico como Kulturo puede ayudarte a convertir un problema ambiguo en una vacante evaluable.
Cómo evaluar a un ETL Developer en tu proceso de selección
La mayoría de procesos para contratar un ETL Developer filtran mal. Premian CVs llenos de palabras clave y descartan perfiles que sí saben construir pipelines útiles. Si quieres contratar bien, deja de hacer preguntas de manual y empieza a buscar evidencia de trabajo real.
Lo que debes mirar en el CV
Un CV fuerte no es una lista de herramientas. Es una secuencia de problemas resueltos. Si lees “SQL, Python, Airflow, Snowflake, AWS”, aún no sabes nada. Si lees que diseñó pipelines entre fuentes concretas, modeló datos para reporting y mantuvo jobs en producción, ya estás cerca de algo útil.
Fíjate en señales como estas:
- Contexto claro. Qué sistemas integró, para qué equipo y con qué destino.
- Responsabilidad real. Si diseñó el pipeline, solo lo mantuvo o se limitó a ejecutar tareas.
- Relación con negocio. Si entendía métricas, reglas y usuarios internos.
- Mantenimiento. Si operó pipelines con incidencias, cambios de esquema y validaciones.
Descarta CVs donde todo suena genérico. Suelen esconder experiencia superficial.
La entrevista que separa a quien sabe de quien repite teoría
Haz menos preguntas tipo examen y más preguntas sobre decisiones y trade-offs. Un ETL Developer de verdad debería responder con criterio, no con definiciones memorizadas.
Preguntas que sí funcionan:
- “Tienes datos de Stripe, CRM y producto con IDs inconsistentes. ¿Cómo diseñarías la reconciliación?”
- “Un pipeline falla a mitad de carga y deja datos parciales. ¿Cómo lo rehaces para que sea idempotente?”
- “¿Cuándo prefieres ELT frente a ETL clásico?”
- “¿Cómo validas que una transformación no rompe reporting existente?”
- “¿Qué documentas siempre en un pipeline y qué nunca dejarías implícito?”
Buenas respuestas suelen incluir decisiones sobre granularidad, trazabilidad, tests, control de calidad, incrementalidad y manejo de errores. Malas respuestas se refugian en nombres de herramientas.
Si el candidato no habla de datos rotos, esquemas cambiantes y validación, probablemente no ha sufrido producción de verdad.
La prueba técnica correcta
No pongas un algoritmo inútil ni una batería de SQL académica. El reto debe parecerse al trabajo real. Da un pequeño set de CSVs o tablas con datos de clientes, suscripciones y eventos. Pide que modele la información, la transforme y responda una pregunta de negocio concreta.
Un buen ejercicio puede evaluar:
- Modelado de tablas intermedias y finales
- Calidad de SQL y estructura del proyecto
- Capacidad para detectar inconsistencias
- Documentación mínima
- Pruebas o validaciones básicas
No necesitas un proyecto gigante. Necesitas ver cómo piensa. Un candidato excelente suele dejar claro qué supuestos hace, qué validaciones incluiría en producción y qué partes prioriza si el tiempo es limitado.
Errores de proceso que te harán perder candidatos buenos
Muchos equipos fallan por tres motivos:
- Piden un unicornio que combine analítica, platform, ML, DevOps y ETL.
- Alargan demasiado el proceso para un perfil que suele tener varias conversaciones abiertas.
- No venden el problema técnico. Un buen ETL Developer quiere saber qué sistemas hay, qué deuda existe y qué nivel de autonomía tendrá.
Si tu proceso no distingue entre alguien que ha usado una herramienta y alguien que ha construido una capa analítica fiable, vas a contratar por intuición. Y en este rol, eso suele salir caro.
Salario y demanda del ETL Developer en España en 2026
Voy a ser directo: no hay que improvisar rangos salariales para este perfil. Si publicas una banda inventada o demasiado optimista, perderás candidatos serios. Si te quedas corto, atraerás perfiles más juniors de lo que crees. Y si no publicas nada, filtrarás peor.
El dato sólido de mercado que sí conviene tener en la cabeza es otro. La demanda de talento digital en España alcanzó las 31.130 ofertas en 2023, con los perfiles de datos entre las categorías de mayor tracción , según el estudio citado en este análisis sobre carrera de ETL Developer. Eso significa que compites por un perfil escaso dentro de un mercado que ya viene tensionado.
Qué implica esto para un CTO
Implica tres cosas muy prácticas.
Primero, tendrás que ser competitivo en paquete total, no solo en salario. El candidato valora stack, autonomía, claridad de proyecto y madurez del equipo. Un entorno donde todo está por definir puede atraer a algunos. A otros los ahuyenta.
Segundo, no pagues por etiquetas. Paga por capacidad de resolver tu problema. Un candidato con experiencia útil en SQL, modelado, dbt, Airflow y warehouses cloud puede aportar más en una startup que alguien con recorrido en herramientas legacy muy corporativas.
Tercero, define bien el nivel. Si buscas a una persona que entre y ordene datos de producto, billing y CRM casi en solitario, no estás buscando un junior aunque el volumen actual te parezca modesto.
Qué habilidades suelen justificar la parte alta de la banda
Sin fijar cifras no verificadas, sí puede decirse que el mercado suele valorar más a quienes combinan varias de estas capacidades:
- Dominio fuerte de SQL
- Experiencia real con warehouses cloud como BigQuery o Snowflake
- Transformación moderna con dbt
- Orquestación con Airflow, Dagster o Prefect
- Capacidad de modelado para analítica
- Criterio de calidad de datos y operación
También pesan mucho los contextos. No es lo mismo mantener cargas sencillas que construir la base analítica de una scaleup con múltiples fuentes y consumidores internos.
Publica una banda clara, explica el stack de verdad y di qué problema resolverá la persona. Sin eso, compararás candidatos desalineados.
Si necesitas orientación para aterrizar rangos en contratación tecnológica, esta guía sobre banda salarial en España para perfiles tech sirve como marco de referencia general.
Conclusión para contratar el perfil adecuado en tu startup
El ETL Developer correcto para una startup española no es el mismo que contrataría un banco o una gran consultora. Ese es el error de base que veo una y otra vez. Se copia una job description corporativa, se mete un listado de herramientas eterno y luego se espera que aparezca alguien práctico, rápido y con criterio de producto.
En una startup, necesitas un perfil que sea especialista en integración y modelado , pero con mentalidad de generalista. Alguien que pueda tocar APIs, escribir SQL serio, montar transformaciones limpias, operar un scheduler y hablar con negocio sin ponerse estupendo. No necesitas perfección arquitectónica en la primera iteración. Necesitas que el dato deje de ser un problema operativo.
Lo que sí deberías priorizar
Contrata a quien demuestre estas tres cosas:
- Resuelve ambigüedad. Sabe qué hacer cuando las fuentes no cuadran y nadie definió bien la métrica.
- Construye con pragmatismo. No bloquea el avance esperando la arquitectura ideal.
- Deja sistemas mantenibles. Documenta, valida y piensa en la siguiente persona que tocará ese pipeline.
Lo contrario también está claro. Desconfía de candidatos muy centrados en buzzwords de plataforma si no pueden explicarte cómo arreglarían duplicados, cómo diseñarían una tabla de hechos o cómo evitarían que reporting se rompa tras un cambio de esquema.
Startup frente a empresa grande
Una empresa grande puede necesitar a alguien profundo en Informatica, SSIS o entornos muy gobernados. Tiene sentido si el contexto exige estabilidad extrema, procesos largos y compatibilidad con legado.
Una startup suele necesitar otra cosa. Más stack moderno, más autonomía y menos apego a una herramienta concreta. Fivetran o Airbyte, dbt, BigQuery o Snowflake, Airflow y buen SQL suelen dar más rendimiento real que una obsesión por soluciones pesadas. El mejor candidato no siempre es el más especializado en una sola plataforma. Suele ser el que entiende el flujo entero y toma buenas decisiones con velocidad.
Contrata por criterio técnico aplicado. No por checklist.
Si además trabajas con equipos distribuidos o necesitas contrastar perfiles creativos, técnicos y de producto, directorios de talento especializado como Artgonuts pueden ser útiles para mapear perfiles complementarios alrededor del ecosistema digital que acompaña a tu equipo de datos.
La decisión final es simple. Si tus métricas dependen de procesos frágiles, si cada dashboard abre una discusión y si el negocio crece más rápido que tu capa de datos, el momento de contratar ya ha llegado. Busca a alguien que convierta datos dispersos en una infraestructura fiable. Eso es lo que hace un buen ETL Developer. Y eso es lo que separa a las startups que reportan de las que realmente operan con datos.
Si necesitas ayuda para definir la vacante, filtrar señales reales de calidad y cerrar un proceso con candidatos alineados con tu stack y fase de empresa, puedes apoyarte en Kulturo. Trabajamos con startups y scaleups en España para contratar perfiles técnicos con criterios de evaluación más útiles que un simple match de keywords.